Also available in
 中文
录阶(LuJie CareerKit)是一个开源的 AI简历 和求职管理工具,可以把简历优化、JD 匹配、投递记录、面试准备和模拟面试放在一个地方做。项目采用 Apache License 2.0,提供在线版,也支持 Docker 自托管和自定义 OpenAI 兼容模型。
如果平时已经在用 ChatGPT 辅助求职,资料很容易越积越乱。
基础简历在 Word 里,看到新岗位就把 JD 丢给 AI 改一版;投递进度记在 Excel 或 Notion;收到面试通知,再回头翻聊天记录找当时分析过的岗位信息。
投两三个岗位还好,数量一多,就很容易分不清哪家公司用了哪版简历、当时针对哪个 JD 改过什么。
录阶就是把这些原本散在不同地方的内容收进一个工作台,让简历、岗位、投递和后面的面试准备继续关联下去。
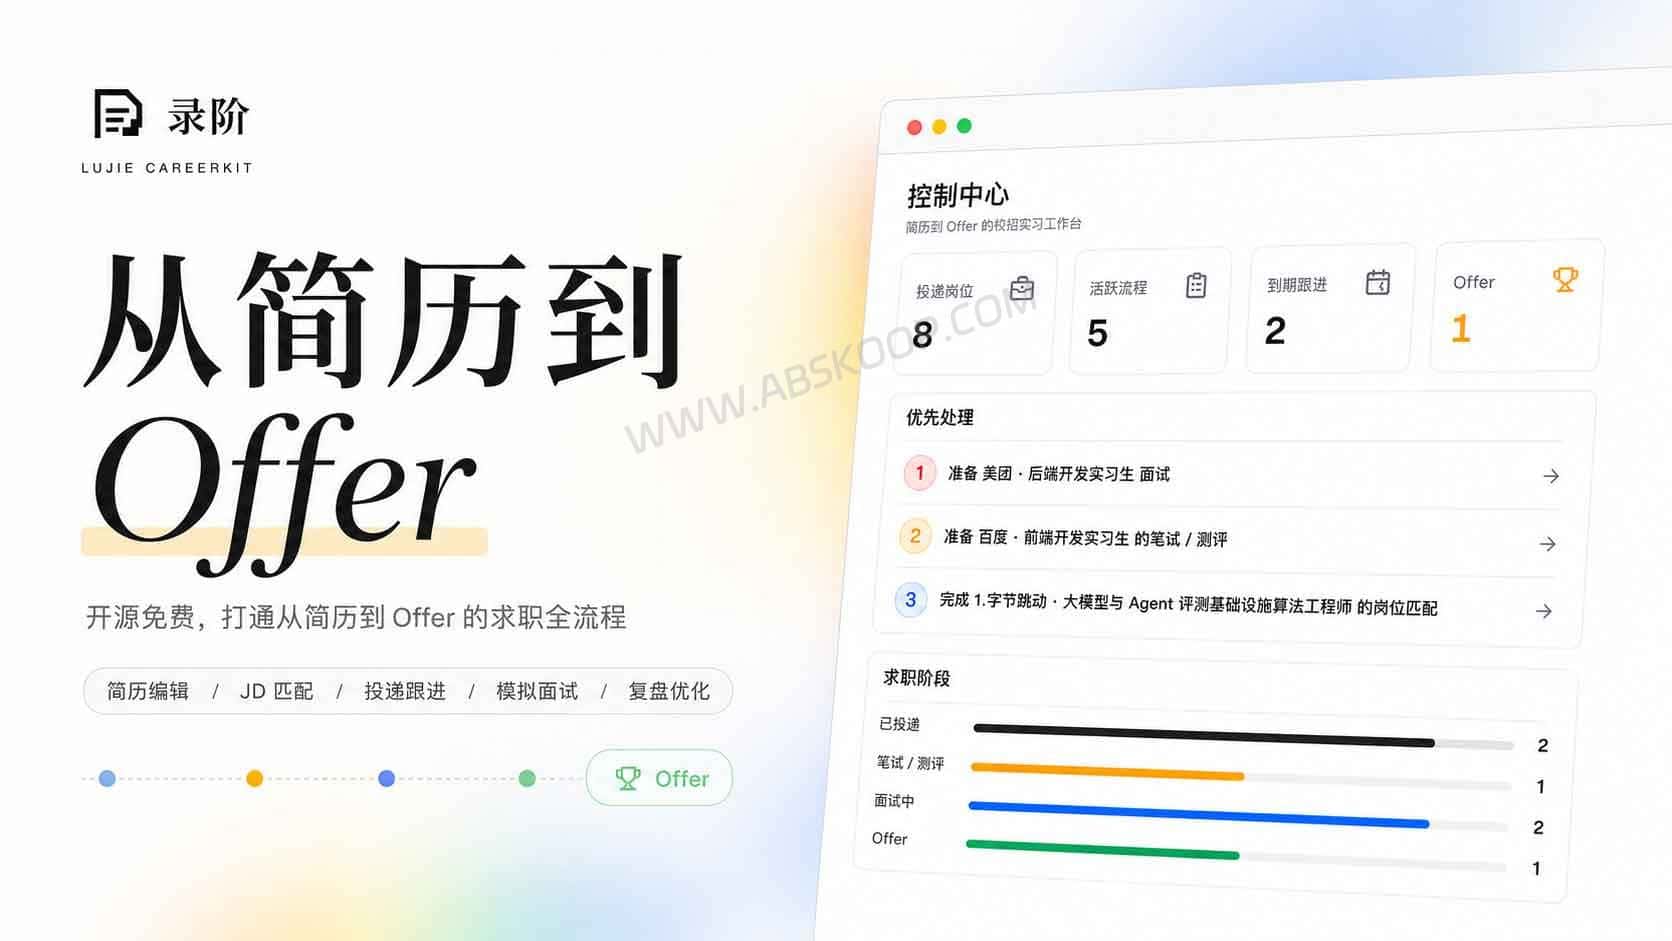
从简历到面试,录阶把求职流程放进一个工作台
录阶和普通简历生成器最大的区别,不是多一个 AI 润色按钮。
如果只是选模板、排版,再导出 PDF,市面上已经有很多成熟工具。录阶更关注一份简历针对具体岗位修改以后,后面的事情怎么继续管理。
你可以先保留一份基础简历,遇到新的岗位时加入完整 JD,让 AI 分析匹配情况,再单独生成这个岗位对应的版本。
投递以后,这个岗位还能继续记录当前阶段、截止日期和跟进时间。后面收到面试通知,准备资料、模拟面试和复盘仍然接在同一个岗位下面。
这样做的好处不是“AI 更聪明”,而是岗位和资料之间的关系不会随着投递数量增加慢慢丢掉。

AI简历优化与 JD 匹配
录阶支持新建或导入简历,再让 AI 对内容进行诊断。
它会从经历表达、行动与结果、事实证据和结构等方面给出修改建议。你可以挑选真正想处理的问题,再生成一个独立版本,原来的简历不会直接被覆盖。
到了具体岗位,可以把完整 JD 加进来。

AI 会结合岗位职责和要求,分析当前经历与岗位之间的匹配情况,再调整内容重点和表达方式。同一份简历和 JD 还可以继续生成求职信、招聘平台招呼语等内容。
比如你原本只是“参与内部后台开发”,模型为了让表达更漂亮,自行补成“负责核心系统架构设计,并将性能提升 40%”,这类内容如果不是事实,到了面试阶段很容易出问题。
录阶采用的思路更接近:
AI 提建议 → 用户核对 → 用户确认 → 再写入简历。
这比直接把整份简历交给模型重写更稳妥。
JD 匹配之后,还能继续准备和模拟面试
简历针对 JD 调整好以后,这些信息不用重新复制一遍,可以直接拿来准备面试。

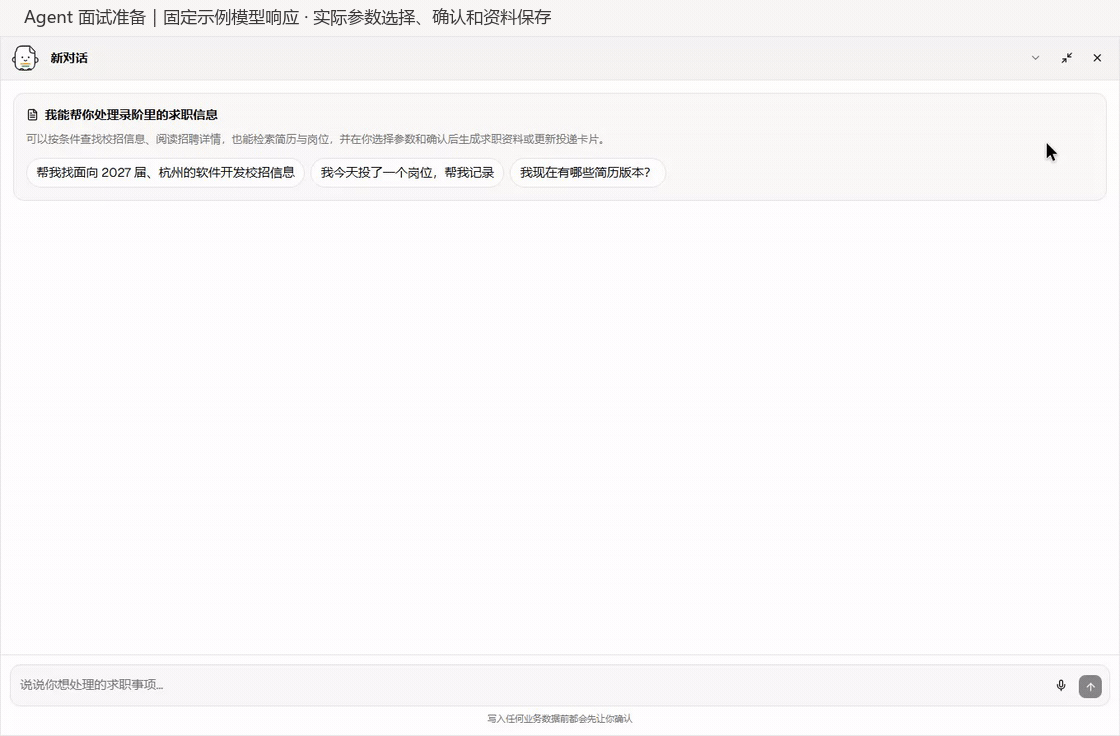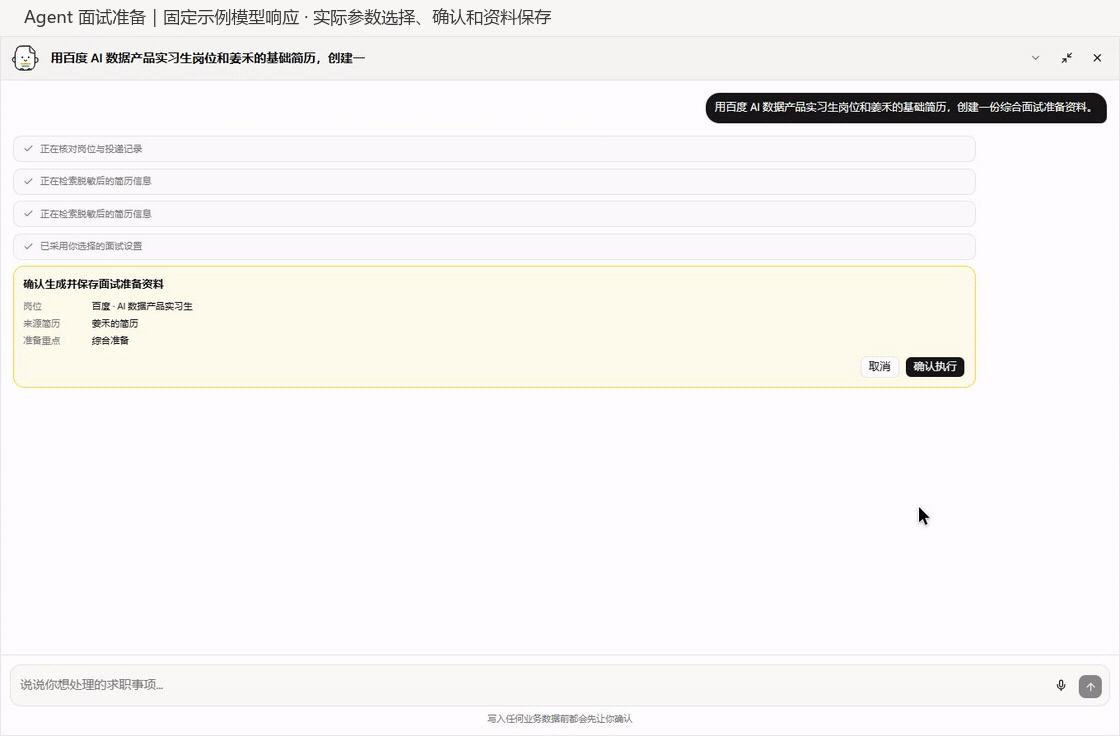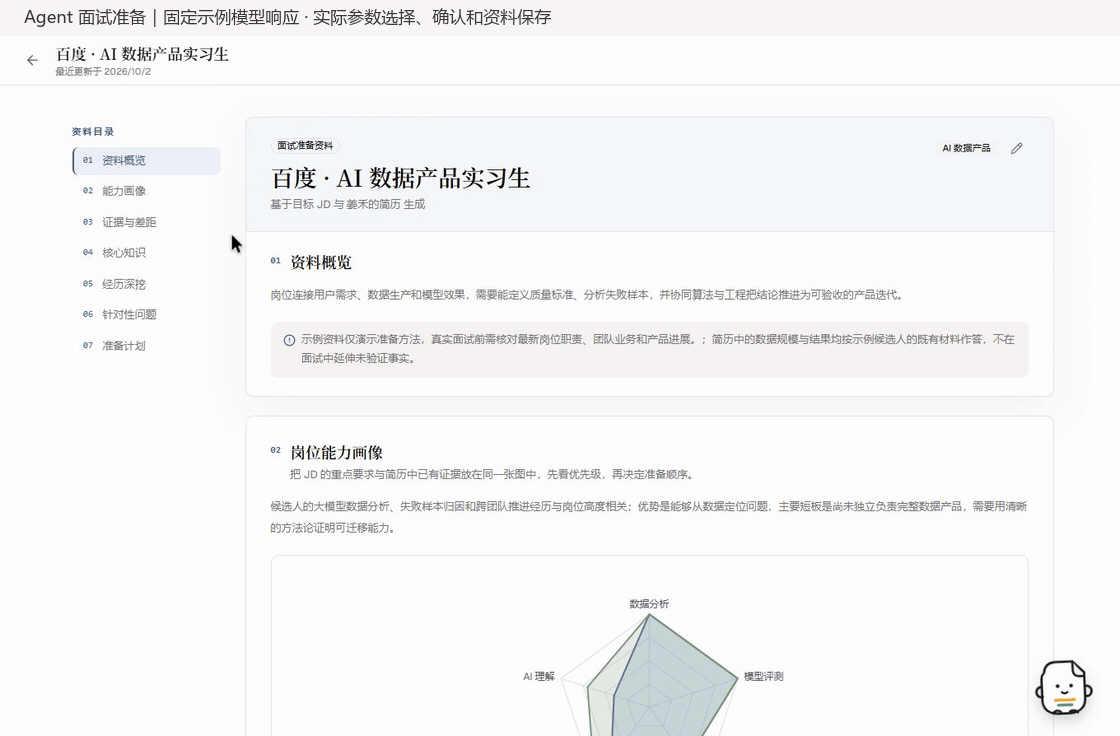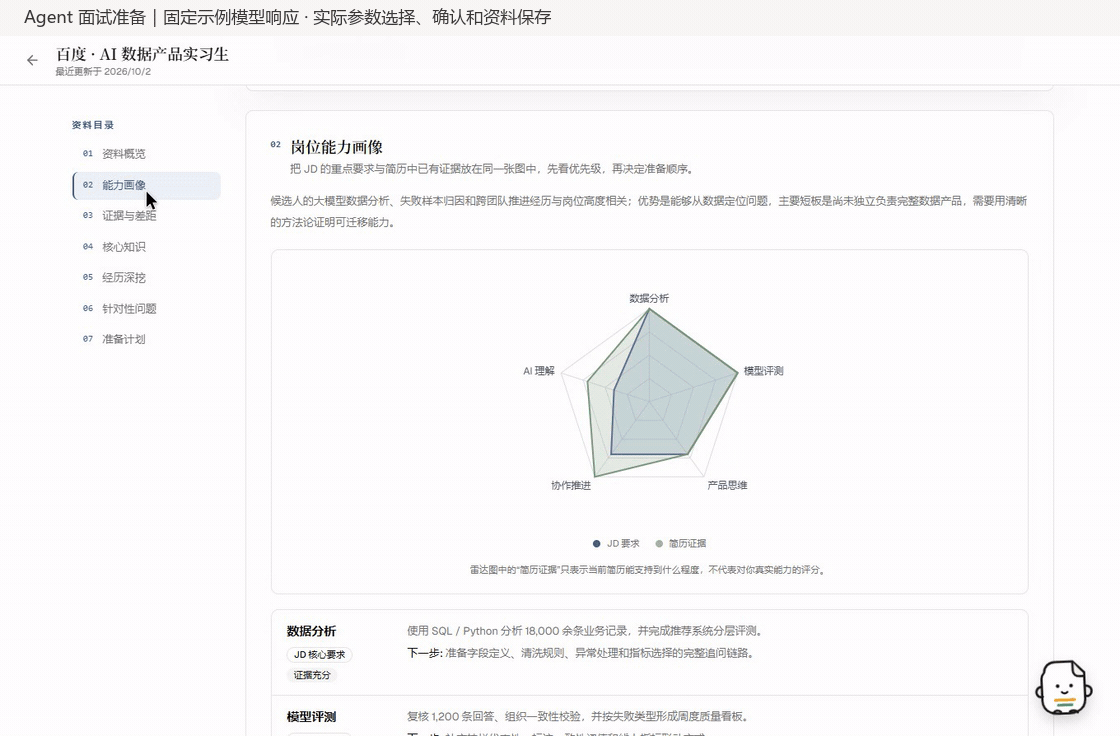
比如你投的是 Java 后端岗位,录阶可以结合这份 JD 和实际投递的简历,梳理岗位更看重哪些能力、哪些经历可能被追问、还有什么地方需要提前准备,再生成对应的问题和准备内容。
到了模拟面试,用的还是前面这套资料。
这和直接打开 ChatGPT 说一句“帮我模拟一个 Java 面试”不太一样。录阶已经知道当前对应的是哪个岗位、哪份 JD,以及这次实际用了哪版简历,后面的提问可以继续围绕这些内容展开。
每道题的回答也可以保存下来,结束后再看 AI 给出的复盘。从改简历、准备面试到模拟练习,不需要每次重新解释一遍背景。
应用内 Agent:写入前仍然由用户确认
录阶还提供了应用内 Agent。
配置模型以后,可以直接用自然语言处理一些求职任务,例如查找已有岗位和投递资料、根据真实经历建立简历、针对完整 JD 生成岗位定制版,以及创建面试准备和模拟面试。
不过它并不是一个可以随意修改所有资料的自动机器人。
涉及真正写入业务数据的操作,需要用户确认后才执行。当前也不会替你登录招聘网站,更不是自动批量海投工具。
对求职场景来说,这个限制反而比较重要。
简历、岗位状态和面试资料里有很多事实信息,如果 Agent 可以无确认修改,最后很容易连自己都不知道哪部分是原始资料、哪部分是模型改过的。
4 个 Agent Skills:Codex、Claude Code 也能直接复用
除了 Web 界面,作者还把几套求职流程整理成了 Agent Skills。
目前仓库提供 4 个:
resume-improvement:分析和优化简历,也可以结合 JD 做岗位定制。prepare-job-interview:围绕公司和岗位整理面试准备资料。mock-interview-coach:逐题进行模拟面试并生成复盘。job-application-writer:撰写求职信、招聘平台招呼语、内推及跟进消息。
已经在使用 Codex、Claude Code 或其他 Agent 工具的人,不一定非要把所有事情都放进录阶的网页界面。
这些 Skill 可以单独复用项目整理好的求职流程。
这部分也是录阶和普通 AI简历生成器差别比较明显的地方:它不只是一个 Web 产品,还把部分求职方法整理成了可以被其他 Agent 调用的工作流。
在线版、自托管版和模型数据会流向哪里
录阶既可以直接用在线版,也可以自己部署。
几种运行方式的数据位置不完全一样:
- 在线预览:个人数据主要保存在当前浏览器。
- 源码本地运行:使用本地 SQLite 数据库。
- Docker:数据保存在自己挂载的数据卷里。
这些运行方式之间不会自动同步。如果自己部署,数据库、数据卷以及相关密钥都要自己做好备份。

这里还有一个很容易混淆的地方:
自托管应用,不等于 AI 处理也一定发生在本地。
如果你接的是 DeepSeek 或其他云端 OpenAI 兼容接口,简历、JD 和面试内容里需要模型处理的部分还是会发送到对应的服务商。
如果本机或服务器已经在跑 Ollama,也可以把录阶接到自己的本地模型服务,让模型这一层也留在自己控制的环境里。
所以两种方式真正的区别,不只是“能不能接上”,还包括数据会往哪里走。
录阶使用 OpenAI 兼容接口,配置时主要填模型接口地址、模型名称和 API Key。不同模型虽然都可能兼容,但简历诊断、长 JD 分析和模拟面试比较吃上下文理解能力,换模型后效果可能会有明显差别。
不配置模型也不是完全不能用。
简历管理、岗位资料和投递记录这类基础功能仍然可以使用。真正需要 AI 的时候,比如简历分析、JD 匹配、面试准备、模拟面试或者 Agent,才需要接模型。
如果使用按 Token 或调用量收费的 API,费用由你选择的模型服务决定。项目开源,并不等于模型调用也没有成本。
Docker 部署与数据备份
如果准备长期使用,或者不想把求职资料一直放在浏览器里,可以直接把录阶跑在自己的电脑、NAS 或服务器上。
Docker 是比较省事的方式。
把下面的 LUJIE_SETTINGS_SECRET 换成自己生成的长随机字符串,再执行:
docker run -d --name lujie-careerkit \
-p 3000:3000 \
-v lujie-data:/data \
-e LUJIE_SETTINGS_SECRET="replace-with-a-long-random-string" \
ghcr.io/chozzc/lujie-careerkit:latest
容器启动后,在浏览器打开:
http://localhost:3000
需要 AI 功能的话,再到设置里填自己的模型接口、模型名称和 API Key。
长期使用时有两样东西最好一起保存:
lujie-data 数据卷,以及 LUJIE_SETTINGS_SECRET。
别只备份数据库。
如果只是体验,跟着 latest 跑比较方便;准备长期使用的话,固定一个自己确认过的镜像版本会更稳,避免后续更新带来兼容问题。
ChatGPT、Reactive Resume、JadeAI 和录阶怎么选
如果只是临时改一段经历,或者让 AI 帮你看看简历和 JD 有哪些地方不匹配,直接用 ChatGPT 就够了。
它更适合一次性的分析和改写。
录阶的区别在于,它会继续保存岗位、简历版本、投递状态和后续面试资料之间的关系。
所以如果只是偶尔改一两份简历,ChatGPT 更省事;同时在推进很多岗位时,专门的求职工作台会更方便管理。
和其他开源简历项目相比,侧重点也不完全一样:
| 项目 | 主要重点 | 更适合谁 |
|---|---|---|
| Reactive Resume | 简历创建、排版与自托管 | 主要需要制作和管理简历的人 |
| JadeAI | AI 简历构建、模板、JD 匹配和求职信 | 更看重 AI 简历生成和模板的人 |
| 录阶 LuJie CareerKit | 简历、岗位、投递、面试和 Agent 工作流 | 需要同时管理多个岗位和多版简历的人 |
如果主要目标是快速做出一份简历,录阶未必是最省事的选择。
如果真正难的是多个岗位之间的资料和后续流程怎么管,它的定位会更合适。
什么情况下用录阶比较合适?
录阶比较适合校招、实习、集中跳槽,或者同时推进多个岗位的人。
这些场景经常不是拿同一份简历一直投。投产品岗可能要突出需求和项目推进,研发岗更看技术细节,数据或运营岗位又要重新调整重点。
这时候为不同 JD 保留不同简历版本,再把投递进度和面试资料接在对应岗位下面,会比单独维护一堆 Word 文件省事。

如果你本来就习惯自己配置 API、用 Docker,或者希望模型用 DeepSeek、Ollama 还是其他兼容服务都由自己决定,录阶这套方式也比较对路。
已经在使用 Codex、Claude Code 的用户,还能直接复用它提供的求职 Agent Skills。
反过来,只想挑个模板,几分钟导出一份漂亮简历,不需要维护很多岗位,也不想碰 API 或 Docker,传统在线简历工具反而更省事。
它也不适合想找“自动海投机器人”的人。
如果你的要求是简历内容完全不能发送给任何第三方模型服务,也需要提前选好本地模型方案,而不是只看应用本身能不能自托管。
录阶目前更适合辅助求职,不适合完全依赖
录阶目前仍是个人开发者维护的开源项目,版本变化比较快。
它和运营多年的商业求职平台不是同一种成熟度。长期使用的话,重要资料建议自己备份,关键简历也最好同时导出 PDF 或 DOCX 留底。
AI简历优化的效果同样不是固定的。
模型能力、简历素材完整程度、JD 写得是否清楚,都会影响结果。
模拟面试给出的分析和评分也只能拿来辅助准备,不能把它当作真实企业面试结果,更不能理解成使用以后就能提高录取率。
把录阶当成整理、分析、准备和管理求职资料的工具,会更符合它现在的定位。
常见问题
录阶 LuJie CareerKit 是免费开源的吗?
项目采用 Apache License 2.0 发布,可以查看源码并自行部署。应用开源和模型调用费用是两回事,如果接入收费的大模型 API,仍然会产生对应的调用成本。
不用 API Key 能用录阶吗?
可以使用简历管理、岗位资料和投递记录等不依赖模型的功能。AI简历优化、JD 匹配、Agent、面试准备和模拟面试则需要可用的模型服务。
录阶的数据存在哪里?
在线预览的数据主要保存在当前浏览器;源码本地运行使用 SQLite;Docker 部署的数据保存在自己挂载的数据卷中。不同运行方式之间不会自动同步。
自托管以后,简历数据还会发送到云端吗?
取决于使用的模型。应用可以部署在自己的设备或服务器上,但如果配置的是 DeepSeek 等云端模型,AI 处理需要的内容仍然会发送给对应的模型服务商。如果模型也使用本地 Ollama 等服务,数据流向会有所不同。
录阶 LuJie CareerKit 项目地址
GitHub:https://github.com/Chozzc/Lujie-Careerkit
在线预览:https://lujie.chozzc.dev/
如果只是偶尔让 AI 改几句话,或者做一份简历,ChatGPT 和普通简历工具已经够用了。
录阶真正派上用场,往往是同时在投很多岗位的时候。不同公司对应不同 JD、不同简历版本,后面还要继续记投递、准备面试,资料很容易越堆越乱。
它做的不是再加一个“AI 改简历”入口,而是把这些原本分散的东西放到同一个岗位下面继续管理。


评论(0)